 奇荐GEOGEO资讯中心
AI 搜索把品牌和“错误场景”绑在一起:一次可复现的关联核对
当 AI 搜索在回答中把品牌与不相关的使用场景、人群或需求强行关联时,企业团队可以按一套固定步骤做一次可复现的关联核对,先分清是“事实错误”还是“语境偏差”,再决定是否以及如何补充公开资料。
一、先分清:是“说错了”还是“放错了场景”
AI 搜索的回答里,品牌名出现的位置和上下文,往往比“有没有提到”更值得注意。一个常见的新问题是:品牌被提及了,但被放进了一个并不匹配的使用场景、人群或需求里。比如一家做工业设备的品牌,在回答“家用小型清洁工具推荐”时被列为候选;或者一个面向专业用户的软件,被描述成“适合零基础个人用户”。这类问题不是事实错误(品牌名、产品名可能都对),而是关联错位。
做核对前,先明确一个假设:AI 回答中的场景关联,可能来自公开资料中品牌与某些关键词的共现,也可能来自模型对同类内容的泛化。我们无法直接观察模型内部,但可以通过固定提问、记录回答、对照公开资料,判断这种关联是否有可追溯的文本依据。核对的目标不是“让 AI 改口”,而是确认品牌在公开信息中的场景信号是否清晰、一致。
二、可复现的关联核对步骤
第一步,固定问题集。围绕品牌可能被误关联的场景,设计 5 到 10 个中性问题,例如“XX 场景下有哪些品牌可选”“适合 XX 人群的工具推荐”。问题中不包含品牌名,避免引导。每个问题用相同措辞、相同语言,在相同或相近的时间段内重复提问。
第二步,记录回答原文。对每个回答,摘录品牌被提及的完整句子,标注它被归入的场景、人群或需求标签。同时记录回答中是否给出理由或来源线索(如“根据公开资料”“常见于某类评测”)。不要只记“提到了”,要记“和什么一起提到”。
第三步,对照公开资料。把记录到的场景标签,逐一在品牌官网、公开产品页、公开报道或公开目录中查找对应表述。假设例子:某品牌在 AI 回答中被归入“入门级家用”,但官网产品页明确写的是“专业场景使用”,且没有面向家用的公开表述。这时可以标记为“公开资料与 AI 关联不一致”。
第四步,区分三类情况。A 类:公开资料中确有该场景表述,但品牌当前已不主推——属于信息时效问题;B 类:公开资料中完全没有该场景表述,AI 关联可能来自同类内容泛化——属于信号缺失;C 类:公开资料中同时存在多个场景表述,AI 选择了非目标场景——属于场景优先级不清。三类情况的处理方向不同,不要混为一谈。
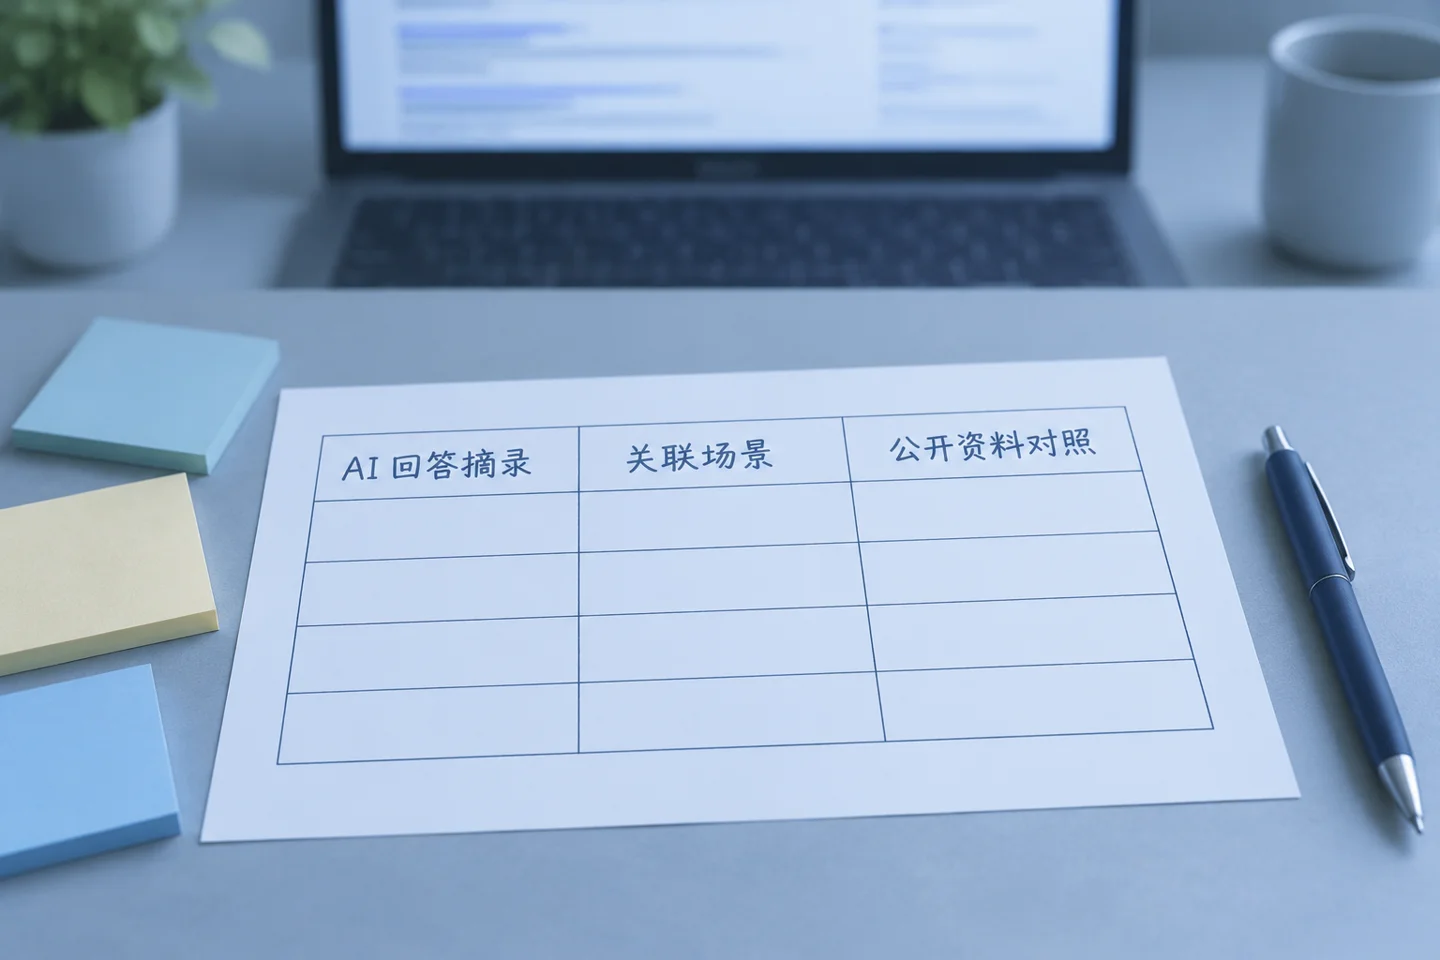
第五步,形成核对记录。用一张表记录:问题、回答原文摘录、AI 关联的场景标签、公开资料对应表述、归类(A/B/C)、是否需补充资料。这张表可以重复执行,换时间、换提问方式后再跑一轮,观察关联是否稳定。
三、适用边界:什么能核,什么不能核
这套方法适用于:品牌在 AI 回答中被归入明显不匹配的场景、人群或需求,且团队希望判断这种关联是否有公开文本依据。它不适用于:判断 AI 平台是否“故意”关联、预测某次回答一定出现或消失、以及把单次回答当作稳定结论。AI 回答具有随机性和上下文敏感性,单次核对只能作为线索,不能作为定论。
另一个边界是:核对能发现“公开资料与 AI 关联不一致”,但不能证明“补充资料后 AI 一定改变”。公开资料的补充是改善信号清晰度的合理动作,但模型如何采纳这些信号,不在企业可控范围内。因此,核对记录的价值在于让团队有依据地决定“要不要补、补什么”,而不是承诺结果。
最后,核对过程本身应避免使用品牌名作为提问关键词,避免人为诱导回答;记录时保留原始措辞,不做转述修饰。这样换一个人、换一个时间,仍能复现同一套观察。